
Пошагово: как проверить индексацию PDF в Яндексе через технический аудит
Чтобы понять, как проверить индексацию PDF в Яндексе, сначала разделите три разных состояния: файл доступен пользователю, робот может получить и обработать его, документ представлен в поиске. Открытие PDF в браузере подтверждает только первое. Для технического вывода последовательно проверьте ограничения формата, ответ сервера, поисковые директивы и дубли.
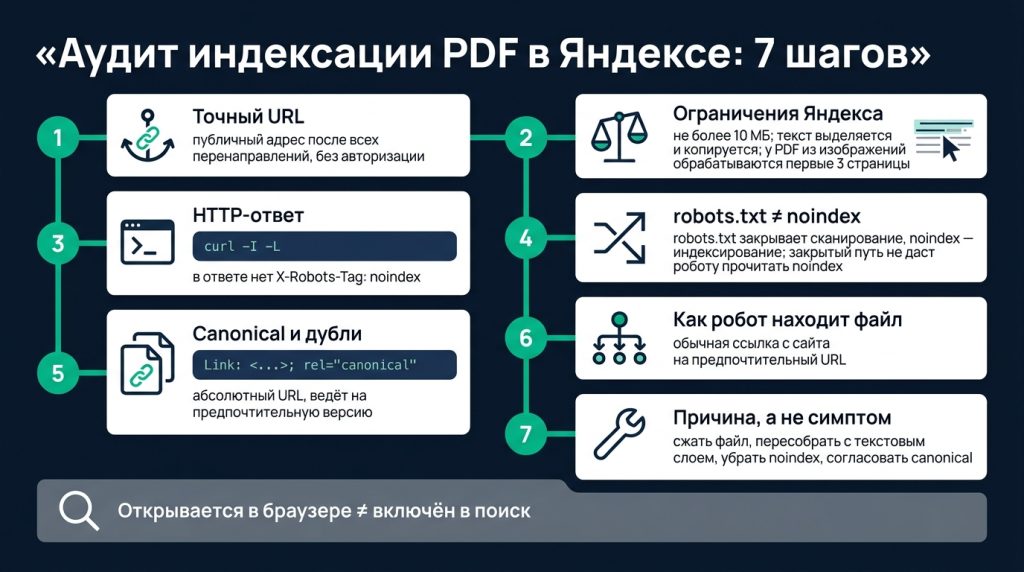
1. Зафиксируйте точный адрес файла
Скопируйте URL из реальной внутренней ссылки, а не из локальной папки или панели управления. Учтите протокол, поддомен, регистр символов, параметры и конечный адрес после перенаправлений. Если один PDF открывается по нескольким URL, запишите все варианты: позже придётся выбрать предпочтительный.
Проверьте, открывается ли адрес без входа в аккаунт, специальной cookie и пароля. Робот должен получить тот же документ, что и публичный посетитель.
2. Сверьте файл с ограничениями Яндекса
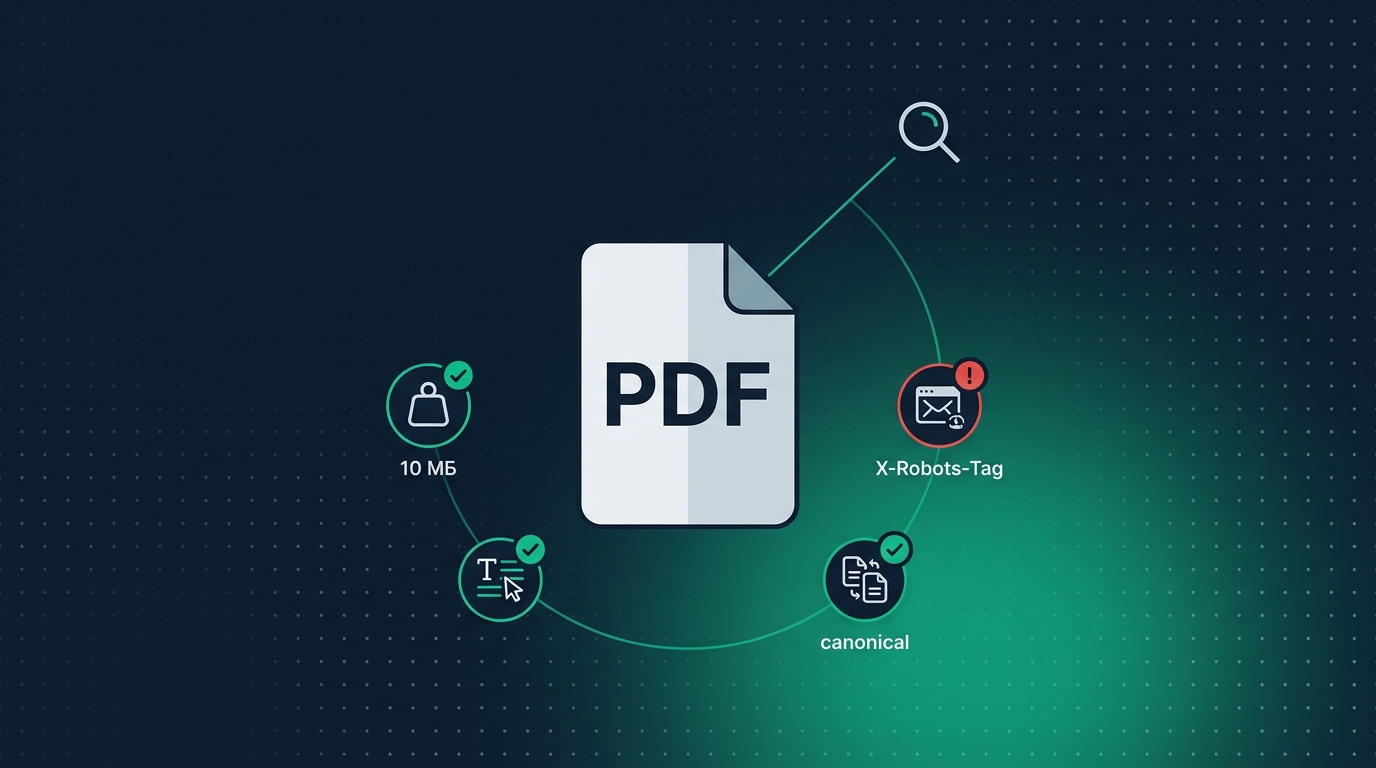
В справке Яндекса для индексируемых PDF указано ограничение по размеру: не более 10 МБ. Проверьте размер самого файла, а не страницы загрузки.
Обычному PDF нужен текстовый слой. Откройте документ, выделите фразу в середине и скопируйте её в текстовый редактор. Если получился читаемый текст, слой есть. Если весь PDF состоит из изображений, Яндекс может распознать текст только на первых трёх страницах. Поэтому не рассчитывайте, что материал за пределами этих страниц полностью доступен роботу в документе из одних изображений.
Отсюда практический вывод: экспортируйте исходник как PDF с текстовым слоем, а не собирайте многостраничный файл из снимков. После экспорта ещё раз проверьте, как копируются кириллица, цифры и заголовки.
3. Получите реальный HTTP-ответ
Проверяйте не только то, как файл открывается, но и заголовки:
curl -I -L https://example.ru/files/catalog.pdf
Параметр `-L` включает переход по перенаправлениям. Конечный ответ должен вести к ожидаемому документу. Заодно убедитесь, что сервер не подменяет файл HTML-сообщением, экраном авторизации или ошибкой.
Особое внимание уделите заголовку `X-Robots-Tag`. Яндекс поддерживает его для управления индексированием документов. Ответ
text
X-Robots-Tag: noindex
запрещает индексировать ресурс. Заголовок может появляться на уровне сервера или промежуточной инфраструктуры, даже если в настройках публикации запрета нет.
4. Разделите robots.txt и noindex
robots.txt управляет сканированием пути, а X-Robots-Tag: noindex — индексированием полученного документа. Это разные механизмы. Чтобы обработать HTTP-директиву, робот должен запросить ресурс. Поэтому закрыть URL от сканирования и при этом ждать, что робот увидит новый `noindex`, логически противоречиво.
Если цель — разрешить показ PDF в поиске, путь не должен блокировать получение файла, а ответ не должен содержать запрещающей директивы. Само разрешение доступа не обязывает поисковую систему включать документ.
5. Проверьте canonical и дубли
PDF может дублироваться на адресе с параметром, в старой папке или в виде близкой HTML-версии. Тогда поисковик выбирает основной адрес. Для документов canonical можно передать HTTP-заголовком `Link`:
text
Link: <https://example.ru/files/catalog.pdf>; rel=»canonical»
Яндекс поддерживает указание канонического адреса документа через этот заголовок. Используйте абсолютный URL. Если основной версией должен быть PDF, заголовок, внутренние ссылки и другие указания должны вести на его предпочтительный адрес. Если canonical направлен на HTML-дубль, отдельный PDF может не быть выбран для показа в поиске.
Canonical применяют для одинаковых или очень похожих документов. Он не предназначен для объединения произвольных страниц только потому, что они на одну тему.
6. Оцените, как робот находит URL
У файла должна быть обычная доступная ссылка с сайта. Адрес, который знает только сотрудник или который передают вне сайта, роботу найти сложнее. Ссылайтесь на предпочтительный вариант URL и не распределяйте внутренние ссылки между дублями.
Страница со ссылкой должна ясно объяснять, что находится в PDF. Это помогает пользователю выбрать формат и снижает риск того, что на сайте будут продвигаться несколько неотличимых адресов одного документа.
7. Исправляйте причину, а не симптом
Если размер превышает ограничение, подготовьте более компактный файл без потери читаемости или разумно разделите материал. Если нет текстового слоя, экспортируйте документ заново. Если сервер отдаёт `noindex`, удалите директиву там, где она добавляется. Если есть дубли, согласуйте canonical и ссылки.
Подробную схему причин содержит [SpeedyIndex](https://blog.speedyindex.com/indeksatsiya-v-google/pochemu-pdf-ne-indeksiruetsya-v-google-i-yandekse-polnyj-razbor-prichin/). Для сравнения с другой поисковой системой можно отдельно воспользоваться [проверкой индексации сайта в Google](https://speedyindex.com/proverka-indeksatsii-sayta-google/): она не исправит размер, отсутствие текста, закрытый доступ или конфликтующий canonical.
Как трактовать результат
Отсутствие файла в выдаче по одному тематическому запросу не доказывает, что его нет в индексе: документ мог просто не попасть в эту выдачу. И наоборот, доступность по прямому URL ничего не говорит о решении поисковой системы. Надёжный аудит фиксирует наблюдаемые условия: точный URL, фактический ответ, размер, извлекаемый текст, директивы и канонический адрес.
После изменений роботу нужно заново получить и обработать документ. Официальные материалы не позволяют обещать ни конкретных результатов, ни обязательного включения, поэтому описывать итог следует без гарантий.
Финальный чек-лист
— Проверен точный публичный URL и все перенаправления.
— PDF доступен без авторизации и пароля.
— Размер файла не превышает 10 МБ.
— Текст корректно выделяется и копируется.
— Для PDF из одних изображений учтено распознавание лишь первых трёх страниц.
— В ответе нет нежелательного `X-Robots-Tag: noindex`.
— robots.txt не мешает получить файл, предназначенный для поиска.
— HTTP canonical содержит правильный абсолютный URL.
— Внутренние ссылки ведут на предпочтительную версию.
— [ ] Доступность не воспринимается как обещание включения в индекс.
FAQ
Индексирует ли Яндекс PDF без текстового слоя?
Для PDF, состоящего из изображений, Яндекс распознаёт текст первых трёх страниц. Чтобы многостраничное содержание обрабатывалось полностью, лучше подготовить настоящий текстовый слой.
Какой заголовок запрещает индексирование PDF?
Для документа можно передать `X-Robots-Tag: noindex` в HTTP-ответе. Яндекс поддерживает эту директиву.
Почему PDF открывается, но не представлен в поиске?
Открытие подтверждает только доступность для пользователя. Среди проверяемых причин — ограничение размера, отсутствие пригодного текста, `noindex`, недоступность для робота и выбор другого канонического адреса.